大白话理解AI的核心概念
你是不是对 LLM、Agent、Prompt、Harness这些概念词搞不清楚?
今天我想用一个视频,把这串概念一次讲清楚、串起来。我保证你看完不只听懂,还能讲给别人听。
想知道 AI 到底在讲什么,我们可以从Agent这个概念说起,先记住一个公式:
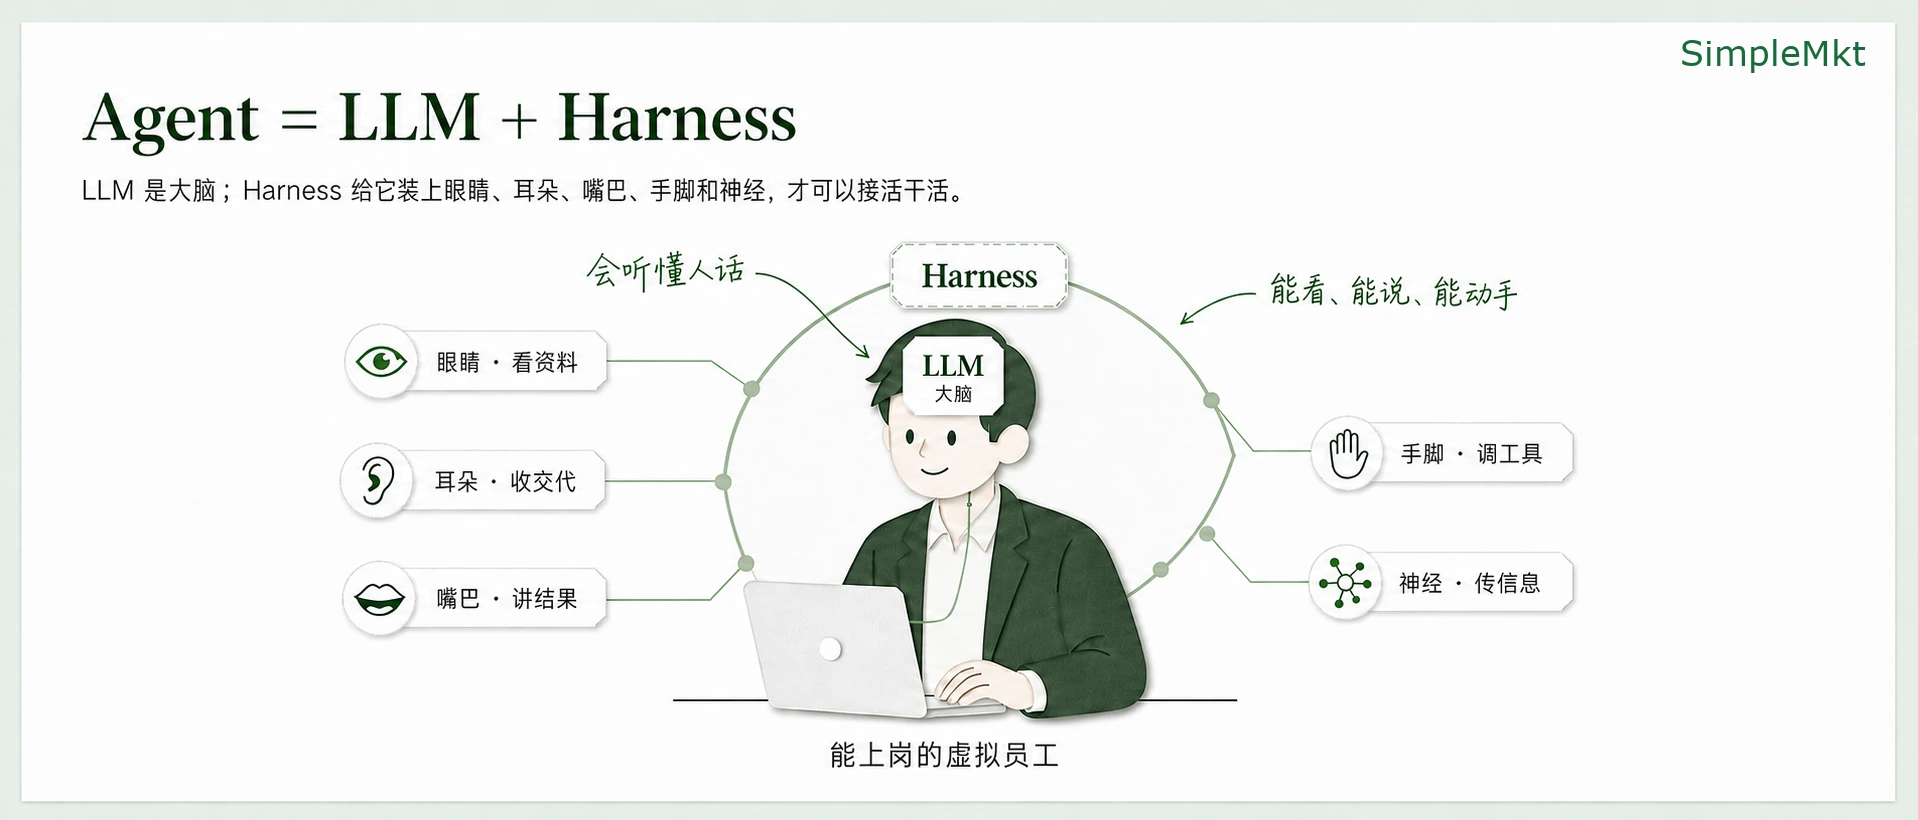
先记住这个公式:Agent = LLM + Harness
Agent = LLM + Harness。
Agent:不是聊天框,而是一个能上岗的虚拟员工
假设你是个老板,你可以把 Agent 想成你刚雇来的一个虚拟员工,这个虚拟员工活在电脑上。
虚拟员工要能干活,先得有一颗会听懂人话、会组织语言的大脑,这颗大脑叫 LLM,也就是我们的大语言模型;但只有大脑还不够,他还得能接收你的交代、开口回答、看资料、甚至动手做事,如果他来专门处理你手头上的事情/业务,也得知道你这个公司中有哪些规矩不能碰,有什么样的SOP要执行。所以你得让这个这颗大脑拥有身体、感官、手脚,然后再给他一些工具,甚至给他搭建能够工作的环境,甚至告诉他怎么去工作。大脑以外的所有的东西,我们就叫 Harness。
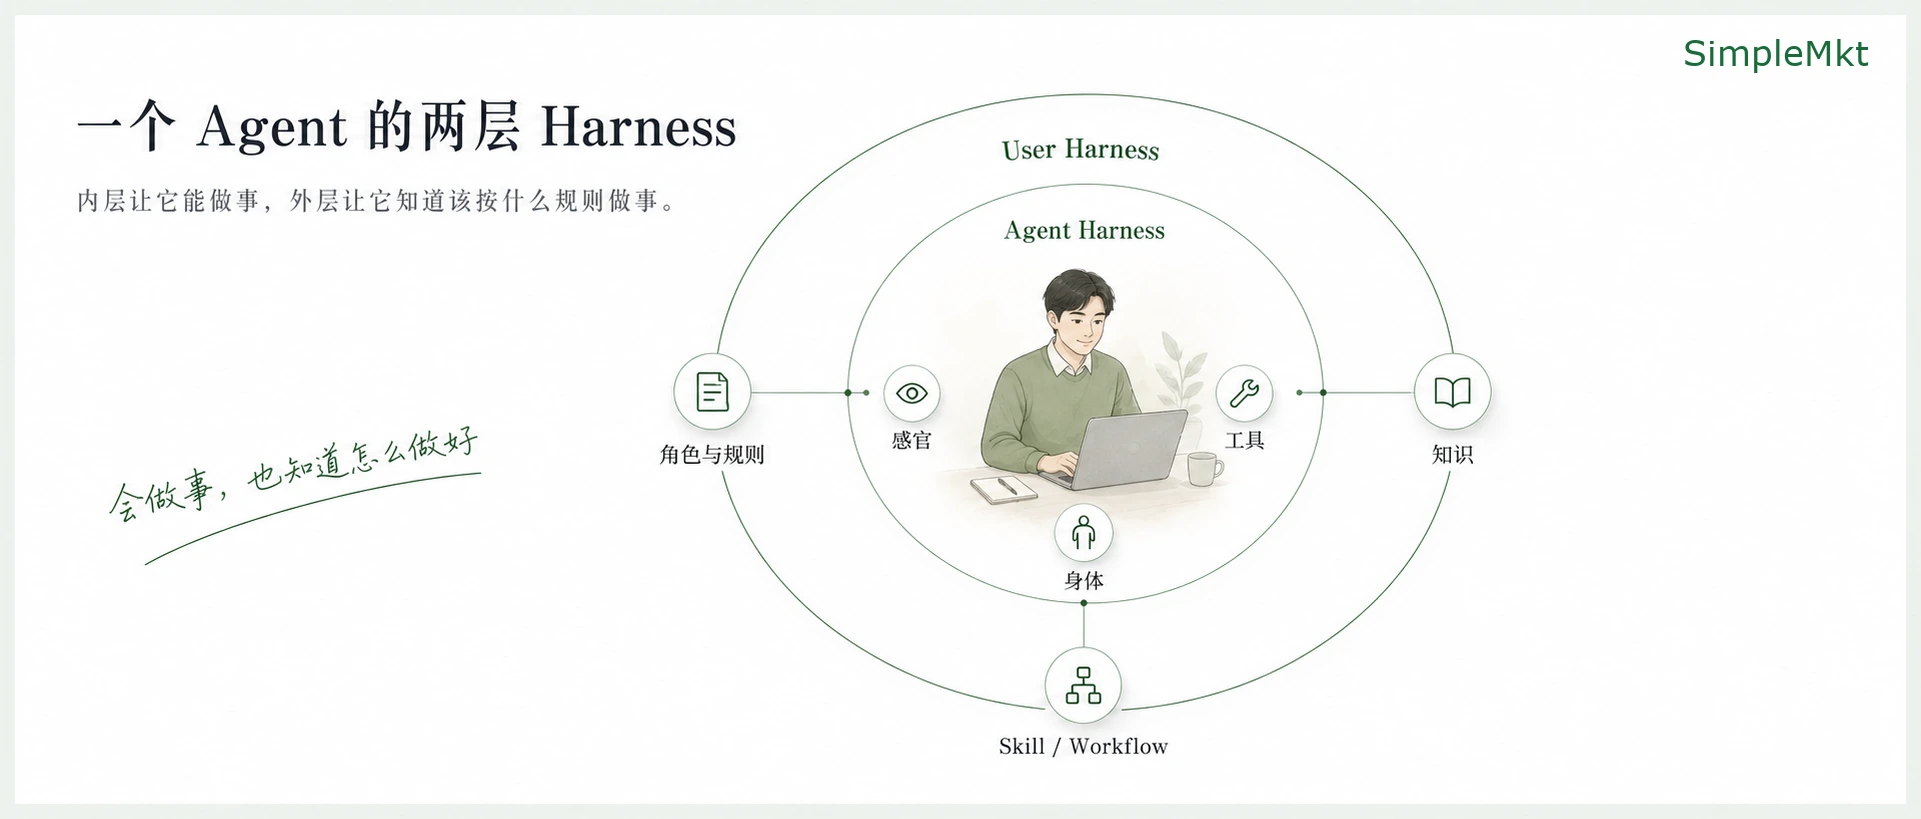
所以一个大模型大脑,成为一个能真正上岗干活的虚拟员工,其实需要两层 Harness:
第一层 Harness:先给大脑装上身体
第一层叫Agent Harness:即身体层面的Harness。这个大脑还没入职时,得有一套运行和调用的身体。比如,看资料的眼睛,接收输入的耳朵,对话和讲结果的嘴巴,调用工具干活的手脚,以及负责在大脑、眼睛、手脚之传递信息的神经系统。那这层Harness通常由大模型公司做 LLM训练、Agent 产品的人去做,逻辑也非常简单,也只有能做好大脑训练的公司和人才能更好地做好大脑调用身体的机制。
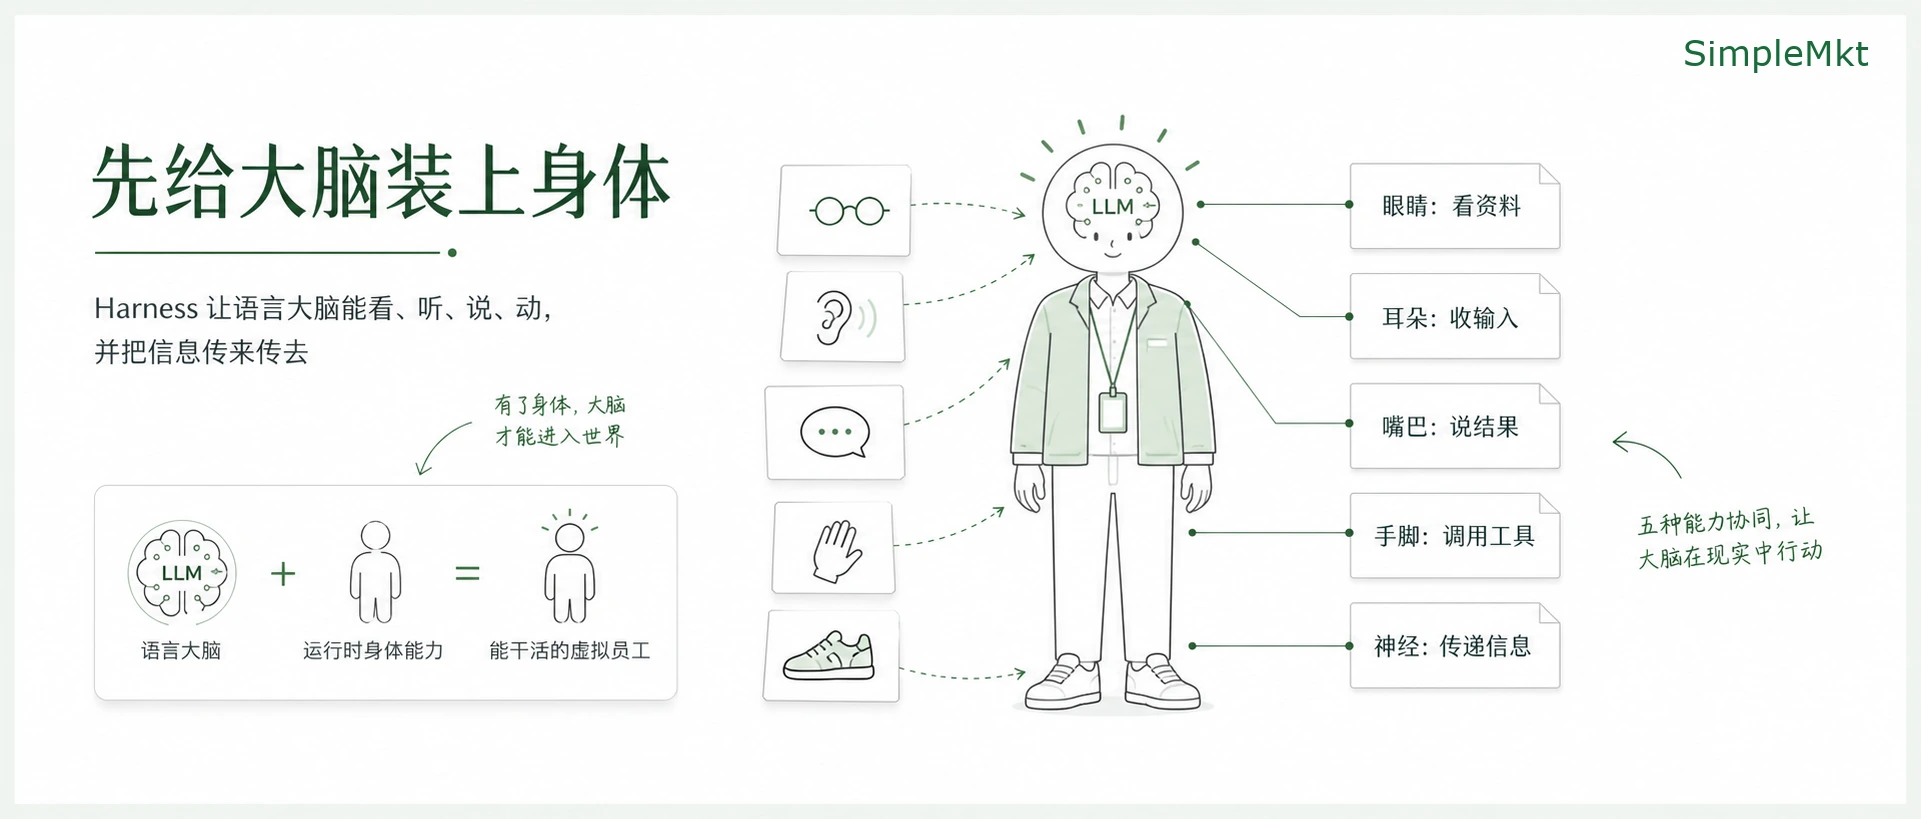
所以我们很多人聊的使用的AI产品本质上都是Agent,而不只是大语言模型。
Chatbot、GUI Agent、CLI Agent:同一个员工,三种外壳
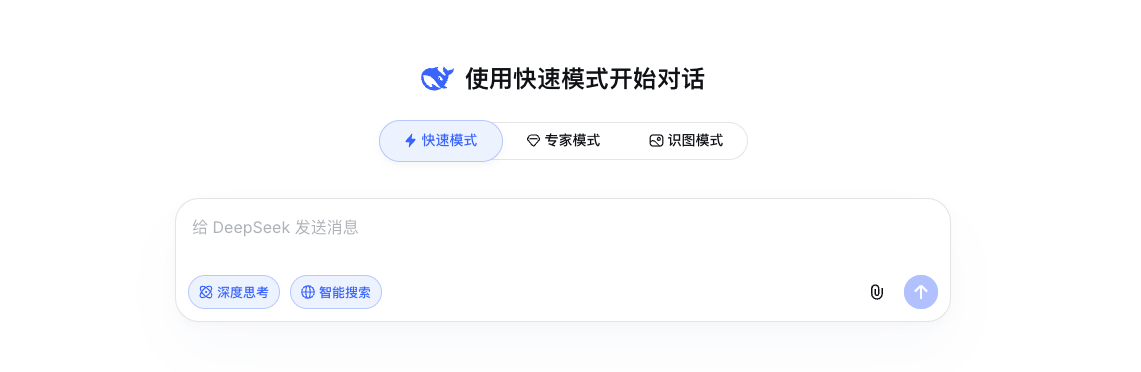
同时,Agent会因为身体Harness外壳的重和轻也分不同的Agent,比如你手机上打开的豆包、deepseek,或者网页端的豆包、deepseek,有对话框的这种,一般我们叫Chatbot,即对话聊天机器人,是一个可以聊天的但无法干活的Agent,他可以读取你的信息,聊天记录,跟你对话,甚至带有一点关于你的记忆,但他无法把手脚伸到你的电脑系统中直接看文件和修改文件。
像Workbuddy、Trae、豆包桌面端这些Agent,就是一个在Chatbot基础上带着手脚和工具,能操作你本地文件的Agent。他们的Harness外壳展现出来给你看到的这个产品形态或外表,叫GUI。一般通过网页和桌面软件的形式和人进行交互,入门门槛会比较低,因为看上去更加简单,底层的代码暴露更加少,很多操作你点点按钮就能实现。按钮的背后本质上一个命令代码,这样子,大部人即使不会写代码,也能通过按钮去输出代码命令。生产这种Agent产品的企业一般都会往里面帮你配置好要使用的工具,相当于少操心、开箱即用。但反过来说,但自由程度低,Harness外壳比较重,LLM去调度这种比较重的外壳,就像开一个很大的机器人,会有带来一定的效果层面的笨重性。
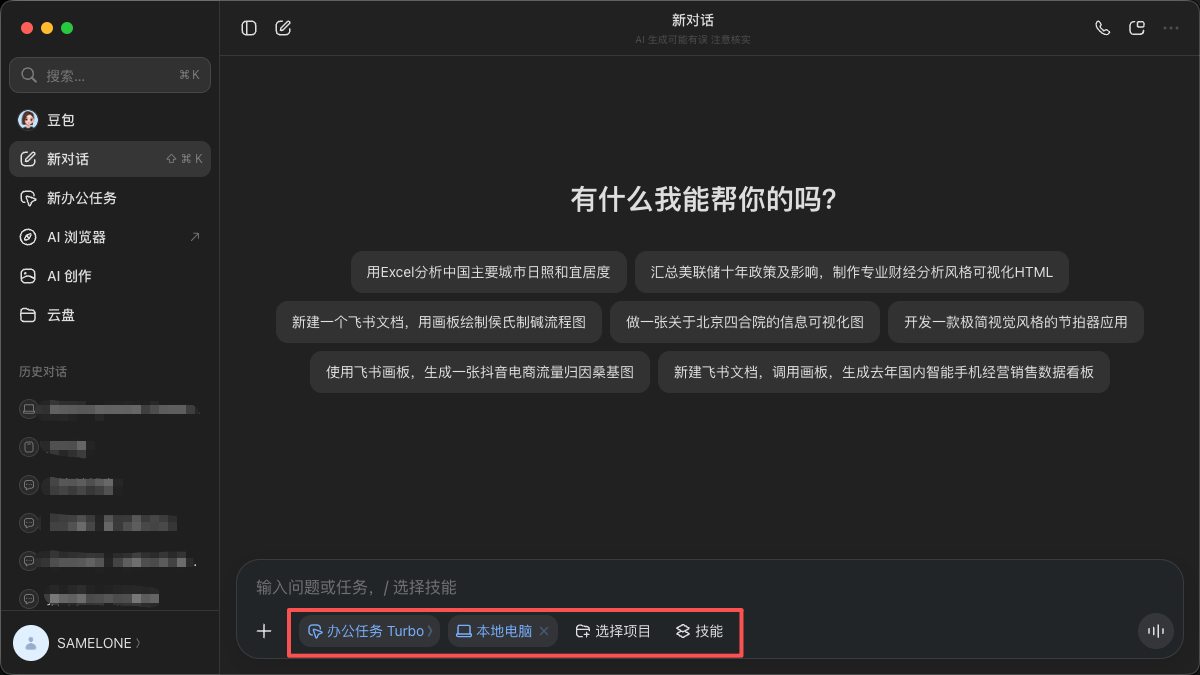
这种Agent做的比较好的,国外的有Codex/Claude Code桌面端,国内的比如腾讯的Workbuddy、阿里的悟空、字节的豆包、还有一些新生代AI公司的比如Minimax桌面端、kimi桌面端、智普桌面端,都是类似的产品。
那这种GUI形态的Agent是从程序员的IDE演化过来的,IDE是程序员写代码的工具和平台,能在里面集中式编写和管理代码,这种IDE产品本质也是GUI。比如之前国外的Cursor和国内的TRAE,都是在IDE中嵌入Agent,现在都转向了这种更加简单易用的Agent形态,主打工作场景,比如XXX Work。
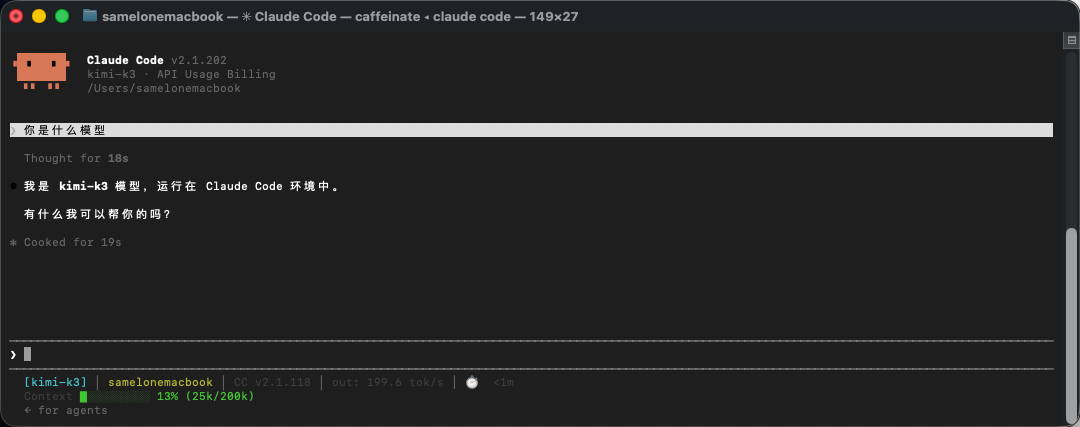
还有一种叫CLI Agent,即在终端的Agent。像Claude Code这种就是CLI Agent(严格意义上来说,claude code是一个Agent Harness,claude code + LLM才是一个Agent,我一般就搭配国内的LLM大脑去使用的,比如Kimi和deepseek)。这种Harness外壳就比GUI Agent轻很多,如果你把GUI比作穿着漂亮的衣服,有嘴巴有眼睛有工具的Agent,那么CLI Agent可能更属于只有轻薄的一层皮肤,眼睛或某些干活的工具都需要你装的那种Agent。但他因为比较接近代码底层,身体束缚更加少,DIY空间更大,干活或执行的效率会更加高。相当于没有那么多背在身上的为了好看和方便的代码要去管理和理解,用得熟练的话,也能更好的理解Agent的底层构造。
但不论如何,我们大部分人拿到手上的,基本就是上述三种形态的Agent。Chatbot、GUI Agent和CLI Agent。根据你自己的学习能力/理解能力选择合适的产品切入。
比如我,最开始就是用的就是Chatbot这种Agent,后来开始使用Cursor、Trae这种IDE形态的Agent,后面转到了Claude Code这种CLI Agent,现在核心在用的是GUI Agent+CLI Agent的组合。如果你想要深度了解Agent的底层原理并希望在Agent上有一定的实操能力,我非常建议你,日常聊天用Chatbot,然后用GUI Agent干活,慢慢进阶到CLI Agent。我的主页中之前写过一个内容叫做《我用AI一年,走了四段弯路,才摸到门槛》,讲的就是我是怎么一步步进化的,这篇文章在我的主页和个人网站simplemkt.cc上也能直接看到。
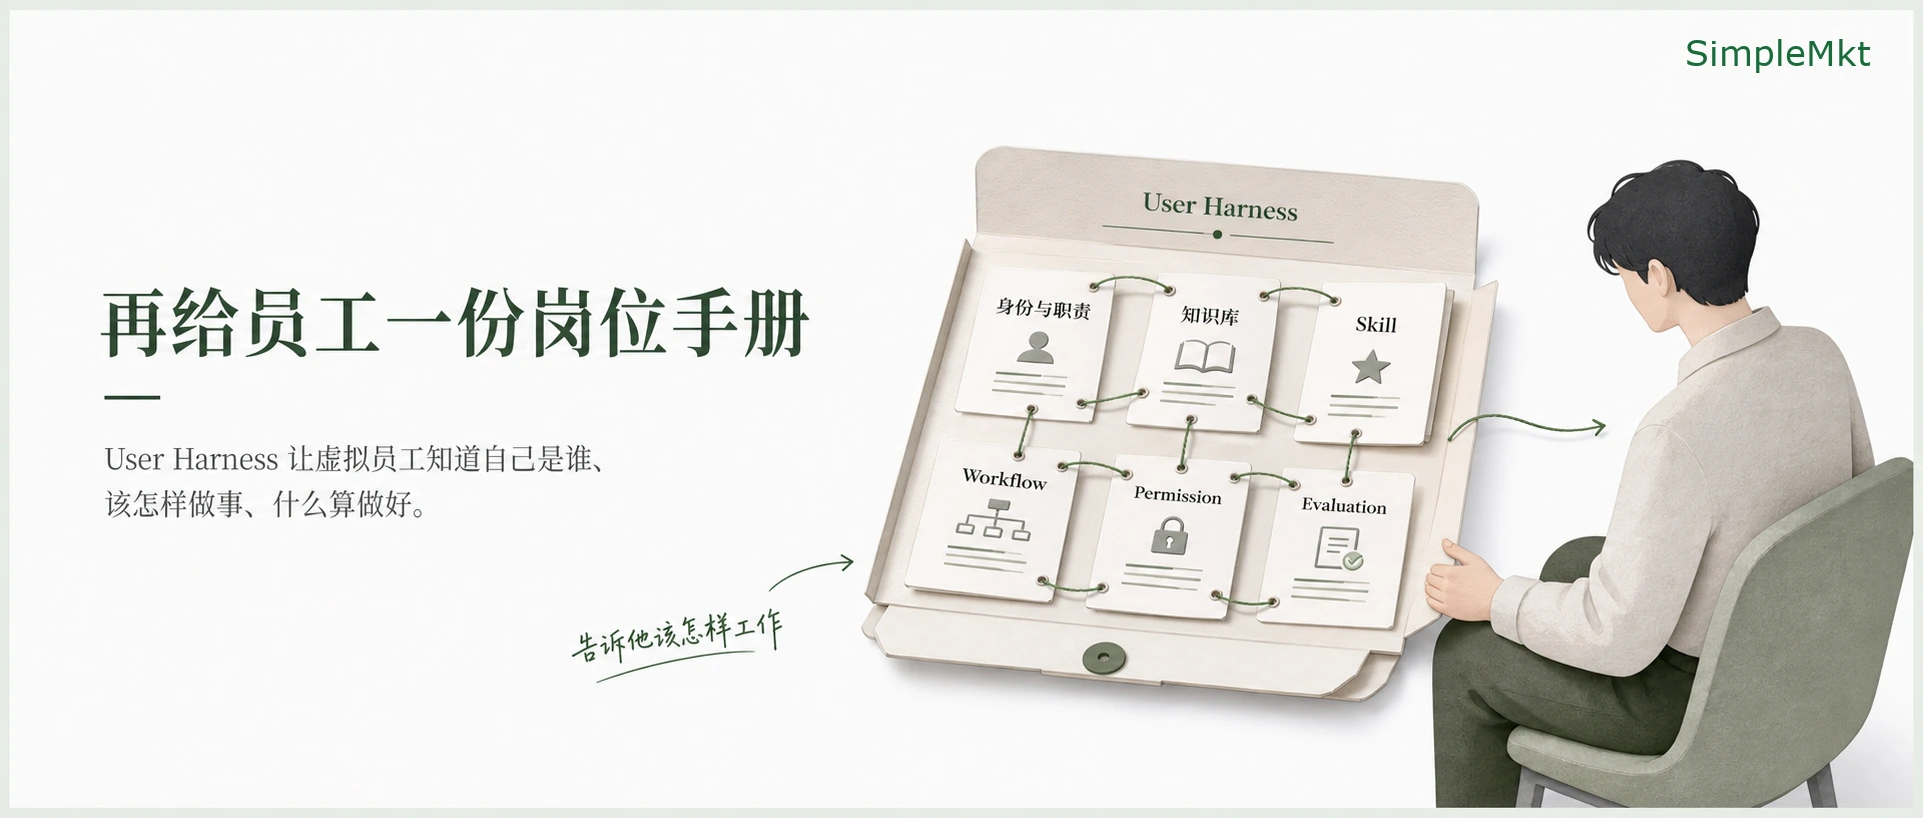
第二层 Harness:再给员工一份岗位手册
那你下载这个Agent产品打开之后,是不是就可以开始干活了?其实也不是。
大部分大公司提供给你的Agent,它的Harness一般都是通用的,不一定符合你的业务需求。它就像大公司给你生产了一个有聪明大脑的大学毕业生,目前的实际情况就是,除了Claude code这种CLI Agent 在 Harness上做的比较好,能够像一个PM一样去做事情。大部分你手上拿到的Agent,它的Harness还都是相对残缺的版本,目前大多就像一个缺胳膊少腿的大学生。能干很多事情,但也有很多事情干不好。
所以,你还得给他补上一些Harness:
- 比如做一些入职培训,这些培训的内容得以文件的形式存储在电脑上让他去读和看和操作,比如知识库的搭建,让他在合适的时机去调用内部知识。
- 你可以给他写一个system prompt,里面去规定这个Agent的身份、职责、什么能做什么不能做;
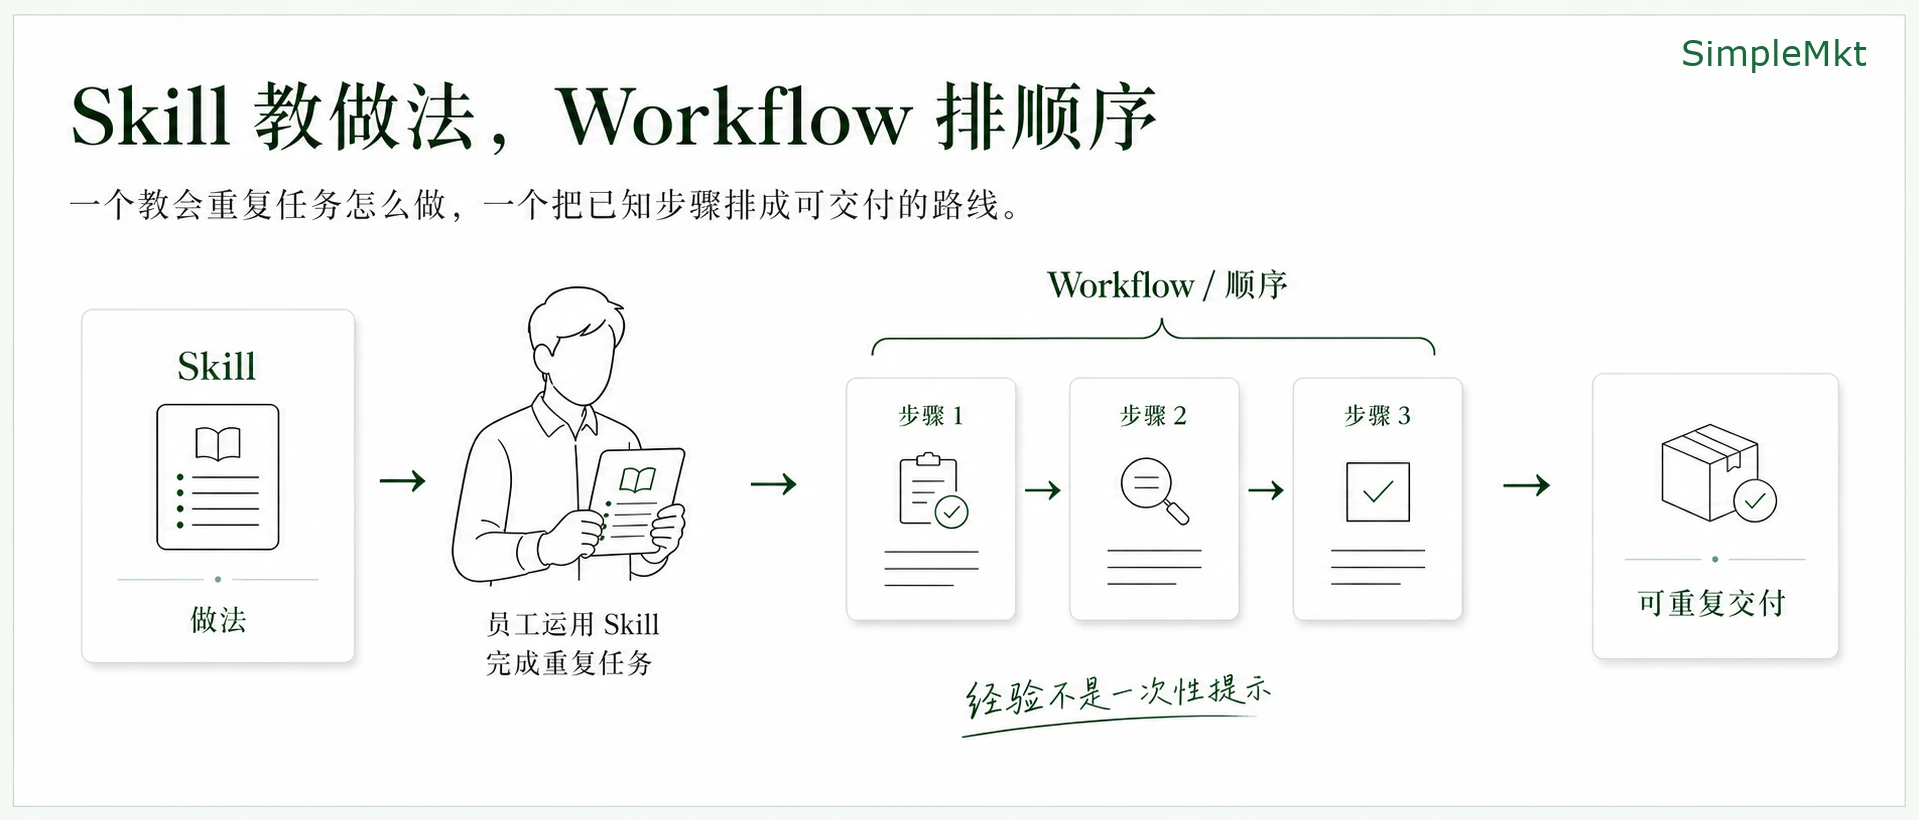
- 你可以给他一个技能说明,教他“如何高效地做好某一类任务”,这个东西又叫 Skill,Skill是按需读取的,又叫渐进式披露;
- 如果你的任务规范涉及“先做什么、后做什么”,你可以把它变成一个叫 Workflow的工作流;
- 如果你划清“哪些地方能碰、哪些必须问我”的强硬的要求,这叫 Permission或者叫Gate,即权限与门禁;
- 做的好不好是不是得评估和审核一下,又可以叫Evaluation,即评估。
这一层Harness统称为叫 User Harness,即使用人层面的Harness,也是大部分人真正能把 AI Agent 用出差异的地方。
这两层Harness合起来,才会让虚拟人既有身体能做事,也知道该按谁的规则做事,怎么样才算做好等等。
一条完整工作链:从 Prompt 到行动,再把结果带回桌面
那这个虚拟的Agent产品是怎么跟我们进行沟通并一层层的去分析消化和执行和产出结果的呢?完整链路是这样的:
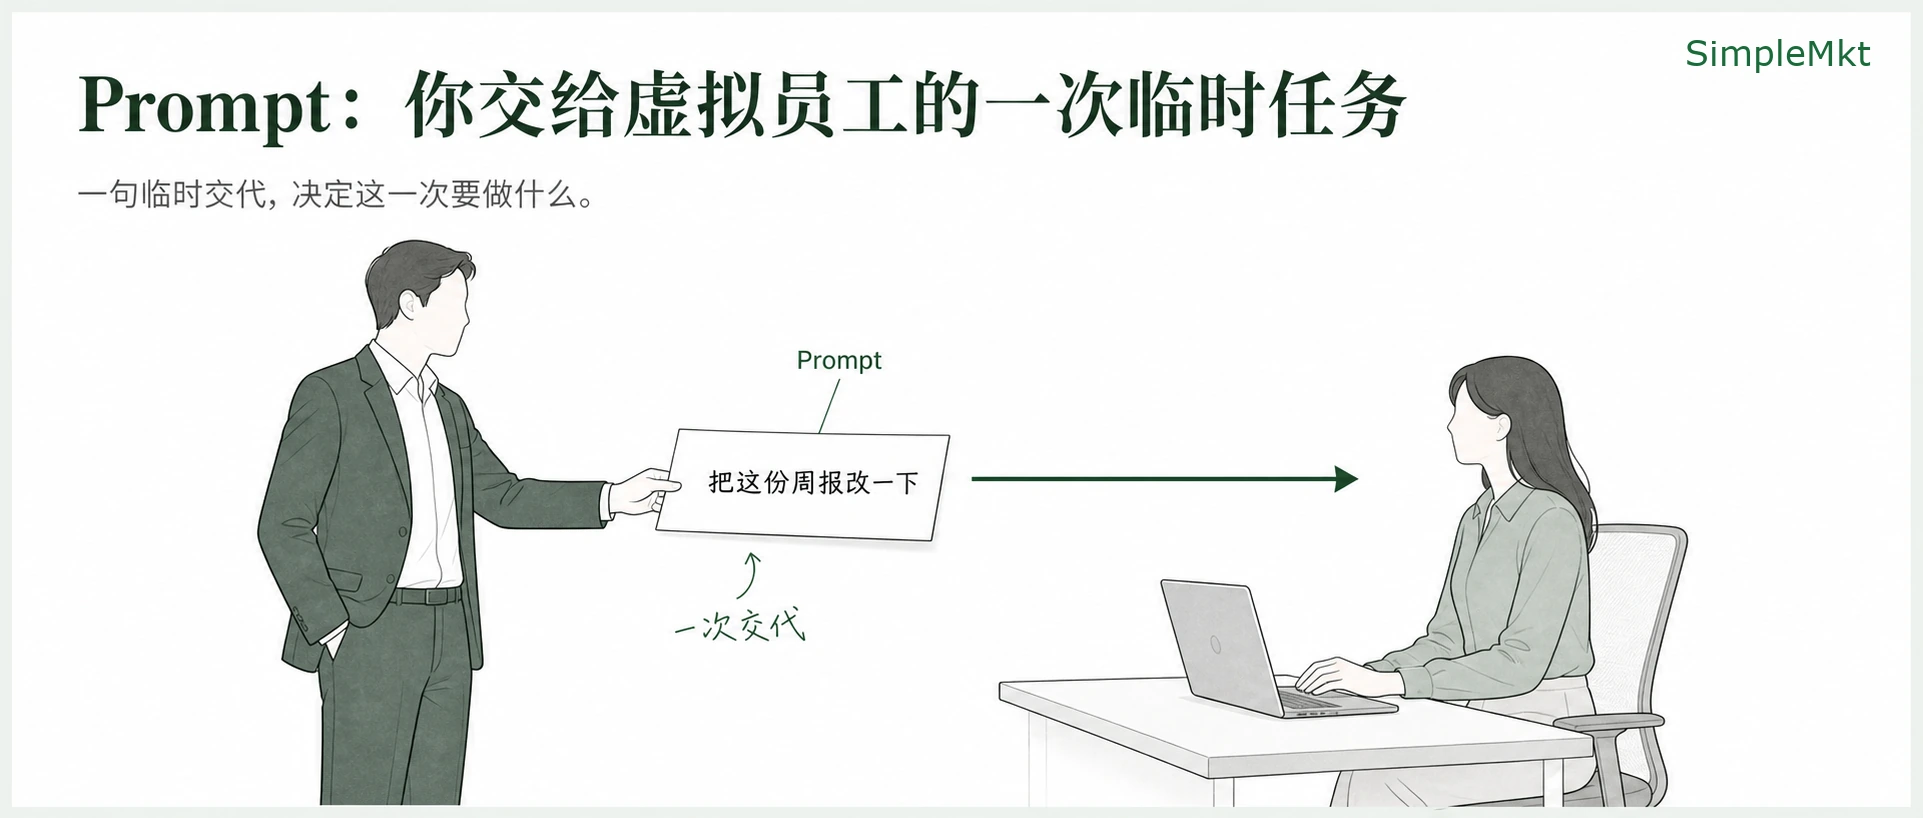
1. Prompt:你交给虚拟员工的一次临时任务
你在对话框里,对这个Agent说:“把这份周报改一下。”这次临时交代,就是 Prompt。你如何把这个Prompt写的好一点让Agent能更好的理解你的需求并产出好东西,就叫Prompt Engineering。
2. Context:大脑此刻摊开的工作桌面
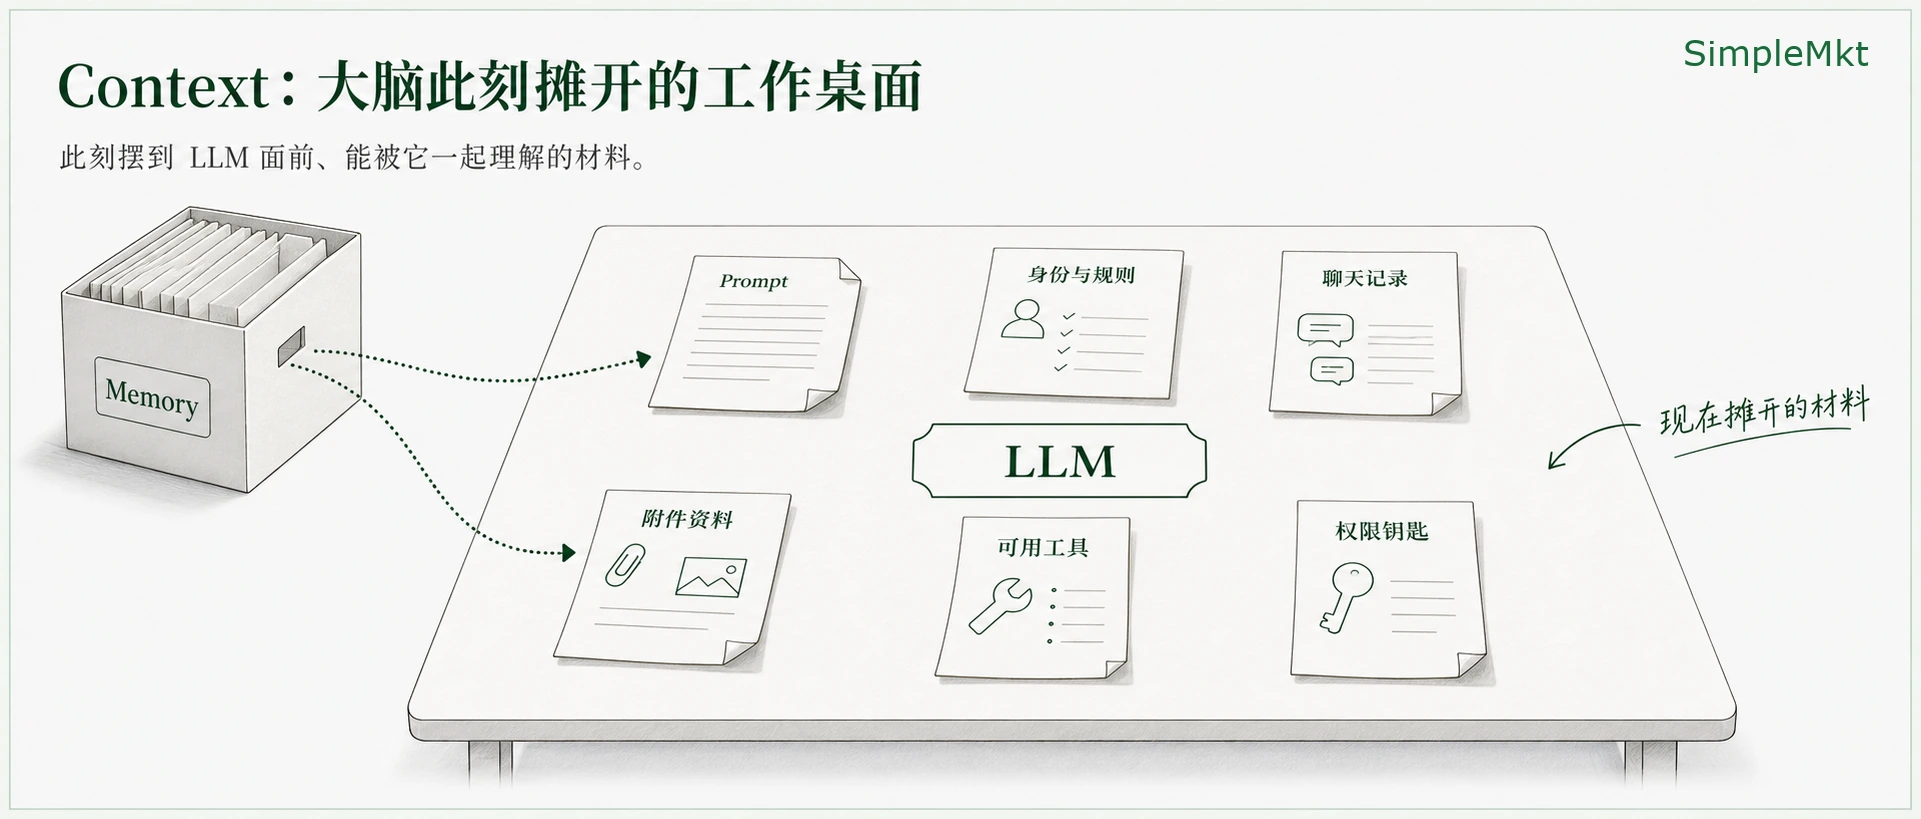
Agent接收到Prompt之后,不会就直接开干。Agent层Harness会先把你给它写的身份、规则、前面的聊天、你这个Prompt中可能带有的附件资料、自己能用的工具和一些权限钥匙一起摊到大脑(LLM)中一张叫做Context的桌上。如果他以前还存过相关资料,他可能先去档案室找和这次有关的几页资料,也一起拿到大脑(LLM)中桌上。这个档案室又可以叫 Memory,那如何高效的去档案室等资料库或外接知识库中读取资料的方式,一般又叫RAG。
3. Chat Template、Token:先把材料整理成大脑能读的语言积木
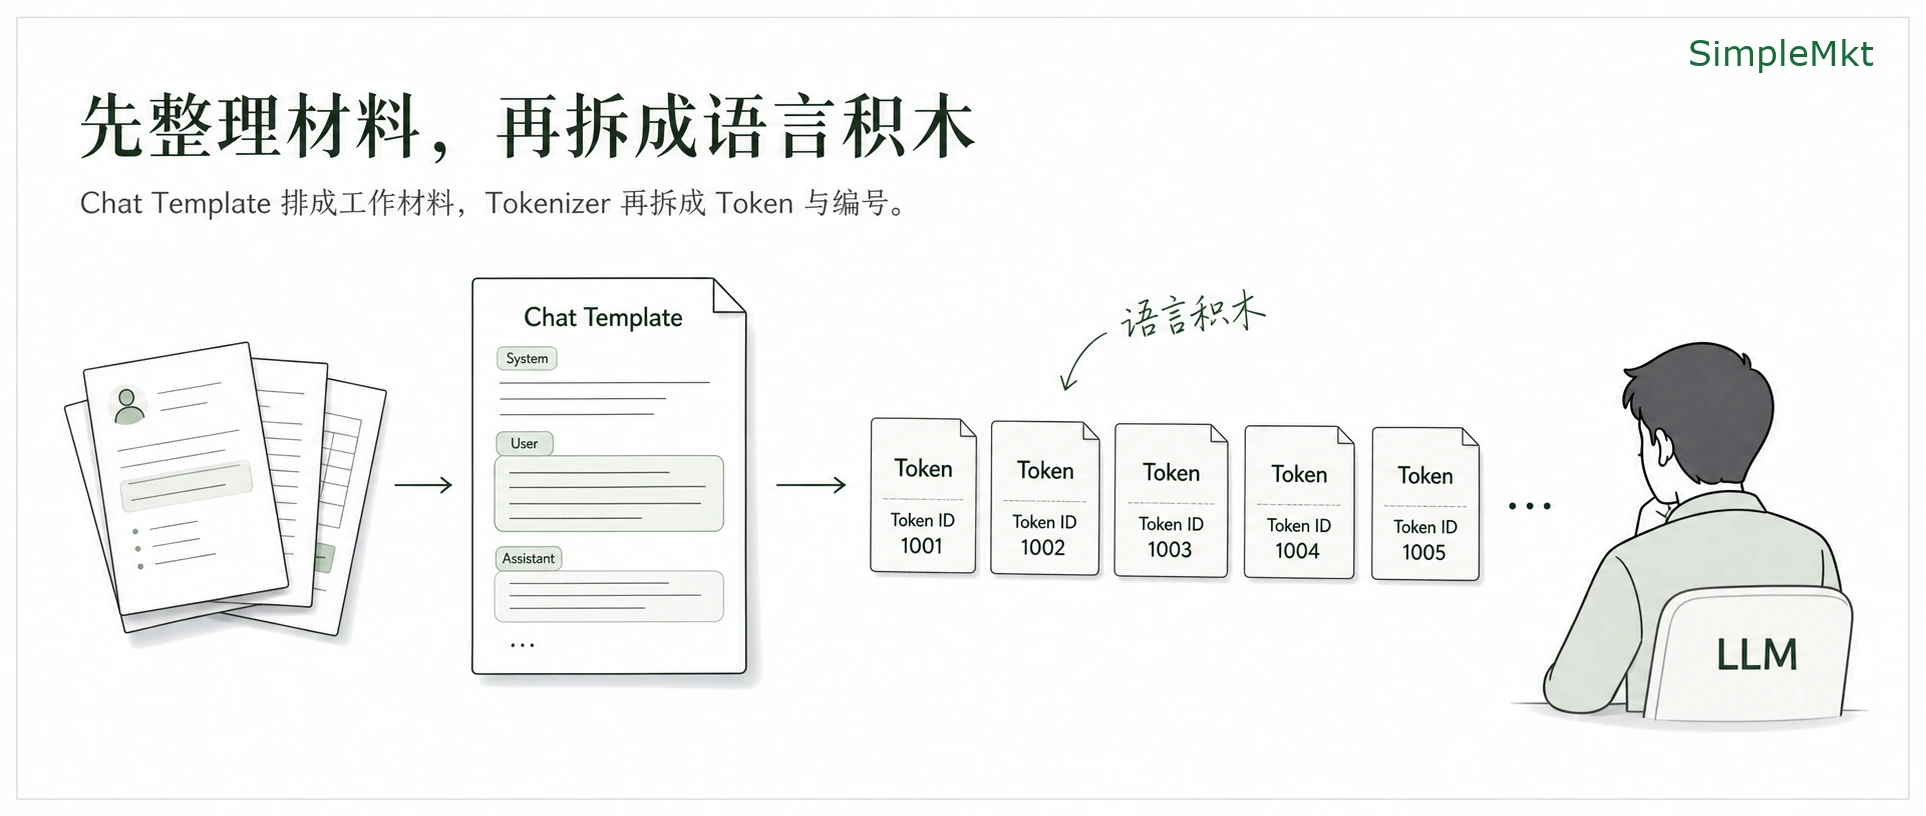
在大脑(LLM)对桌子上的资料正式的分析之前,会有Agent层面的Harness还会把这些资料,排成一份能读的工作材料。然后大脑(LLM)才开始真正的分析,也就是说你发给Agent的所有文字不会都出现在大脑(LLM)中的Context桌子上。接着,它再把所有出现在桌子上的文字拆成一小块一小块的语言积木,也就是一个个“字词”,又叫 Token;每块Token都有自己的编号,叫 Token ID。大脑(LLM)会通过数学计算的方式,来分析这些Token ID之间的关系,并预测后续的Token ID。
4. Transformer、Attention:大脑盯住重点,预测下一个 Token
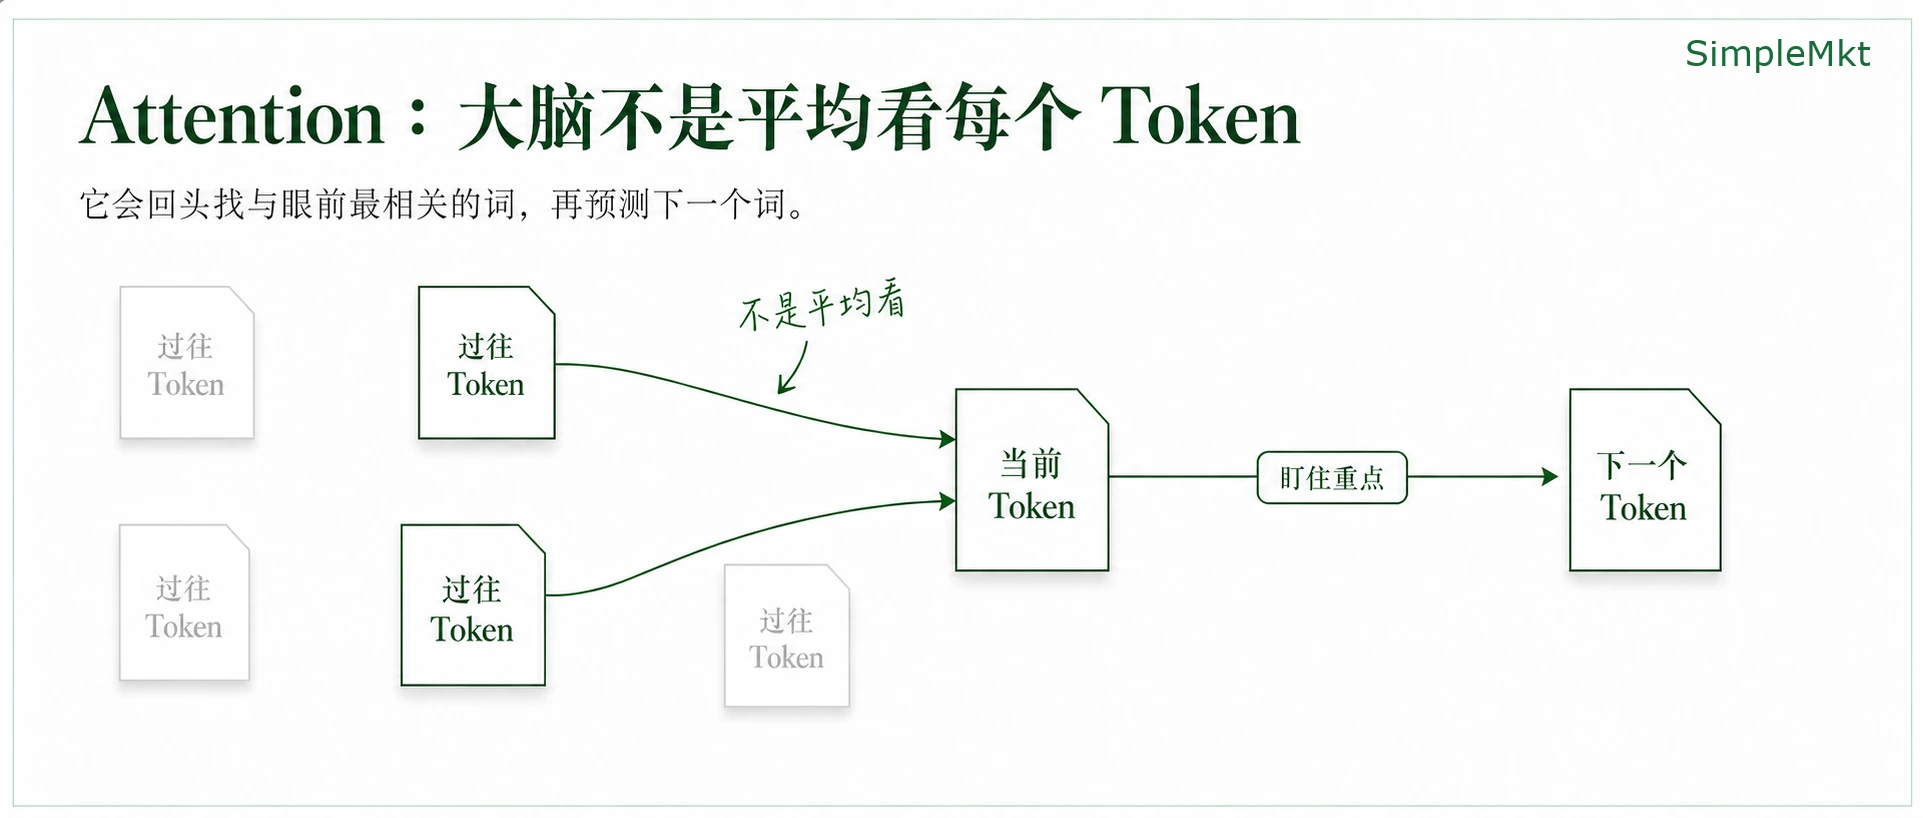
那大脑(LLM)是怎么看和预测Token的呢?这里简单讲一下,大脑(LLM)看桌子上的Token的话,不是桌子上的每个Token都同样重要,他会一边看当下的Token,一边回头看过往的所有Token,并判断哪一Token和眼前的Token最有关,然后作为下一个Token。细节远比这个复杂,需要一定的线性代数和概率论的知识,感兴趣的朋友可以自行了解一下 Transformer的KQV机制;那他这种永远“盯住重点”分析的方式叫 Attention。所以论文名称叫做《Attention is all you need》。大脑(LLM)每次预测的都只是下一个 Token ID,再把ID还原成 Token,Token变成字词,一块一块往后接,然后再通过Agent层的Harness把这段话显示在你看到的界面上。
5. Tool、Permission:大脑决定后,手脚才能行动
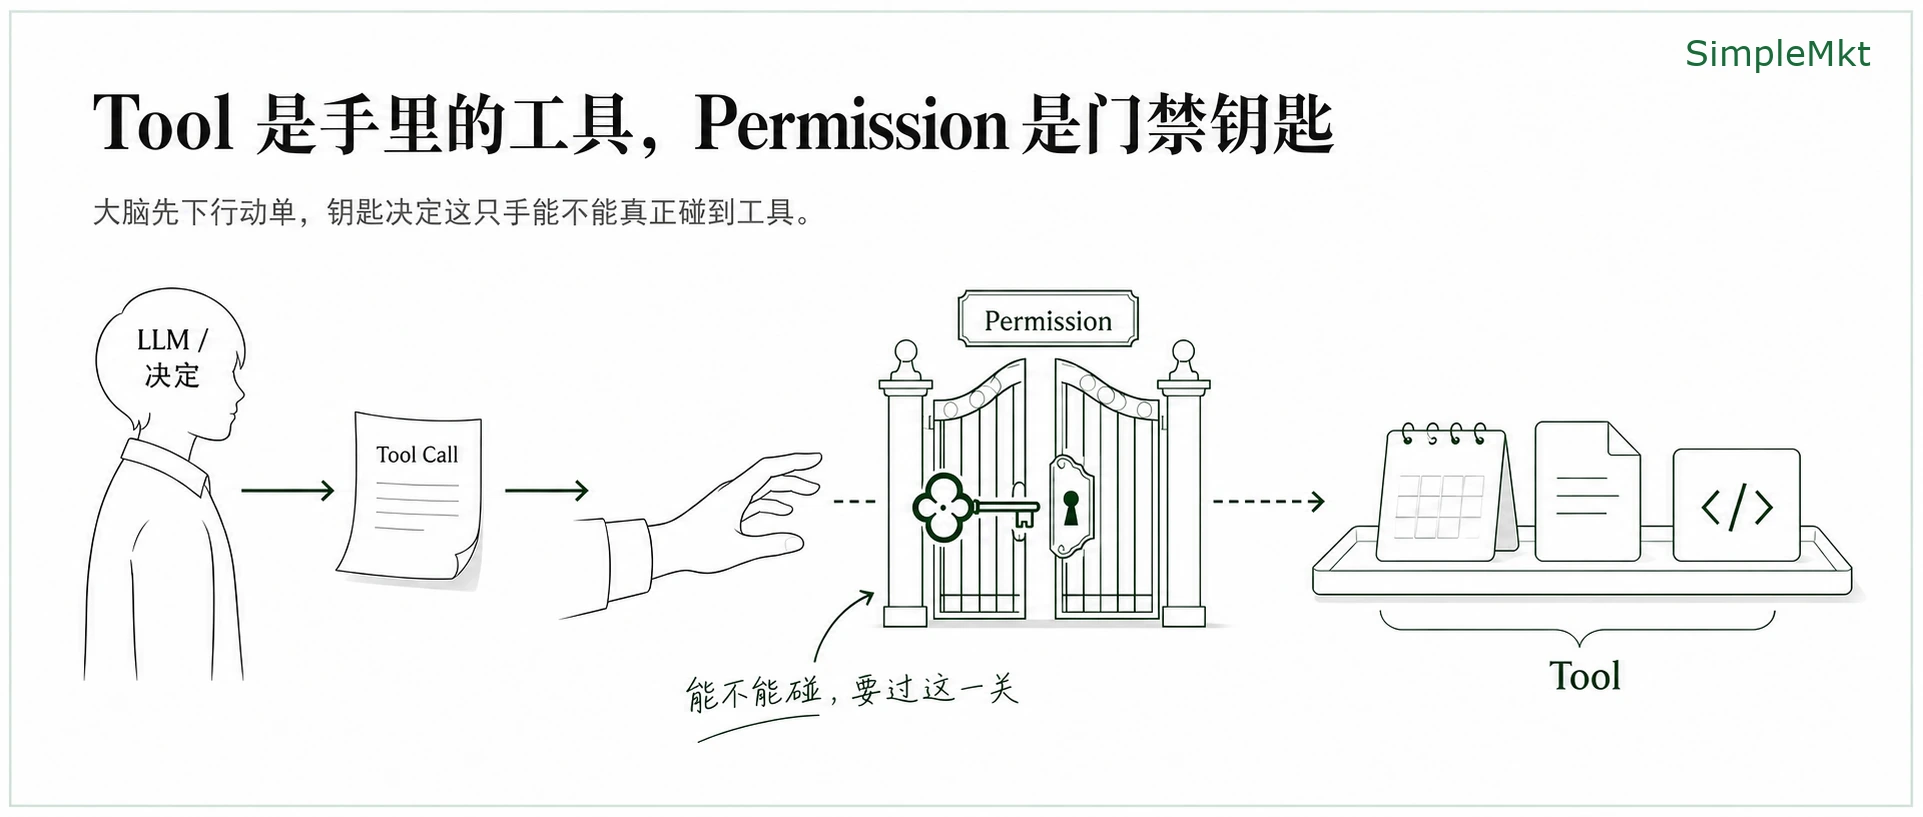
这段话一点点显示在对话框里的方式叫流式输出;如果大脑说“我得去查日历、读文件、改代码”,那Agent层的Harness关于手的部分就去行动并调用工具。手里能用的具体工具叫 Tool,大脑给手下的行动单叫 Tool Call,而 Permission 这把钥匙决定手能不能碰、能碰到哪里。
6. MCP:给外部工具接上统一插座,让结果回到桌面
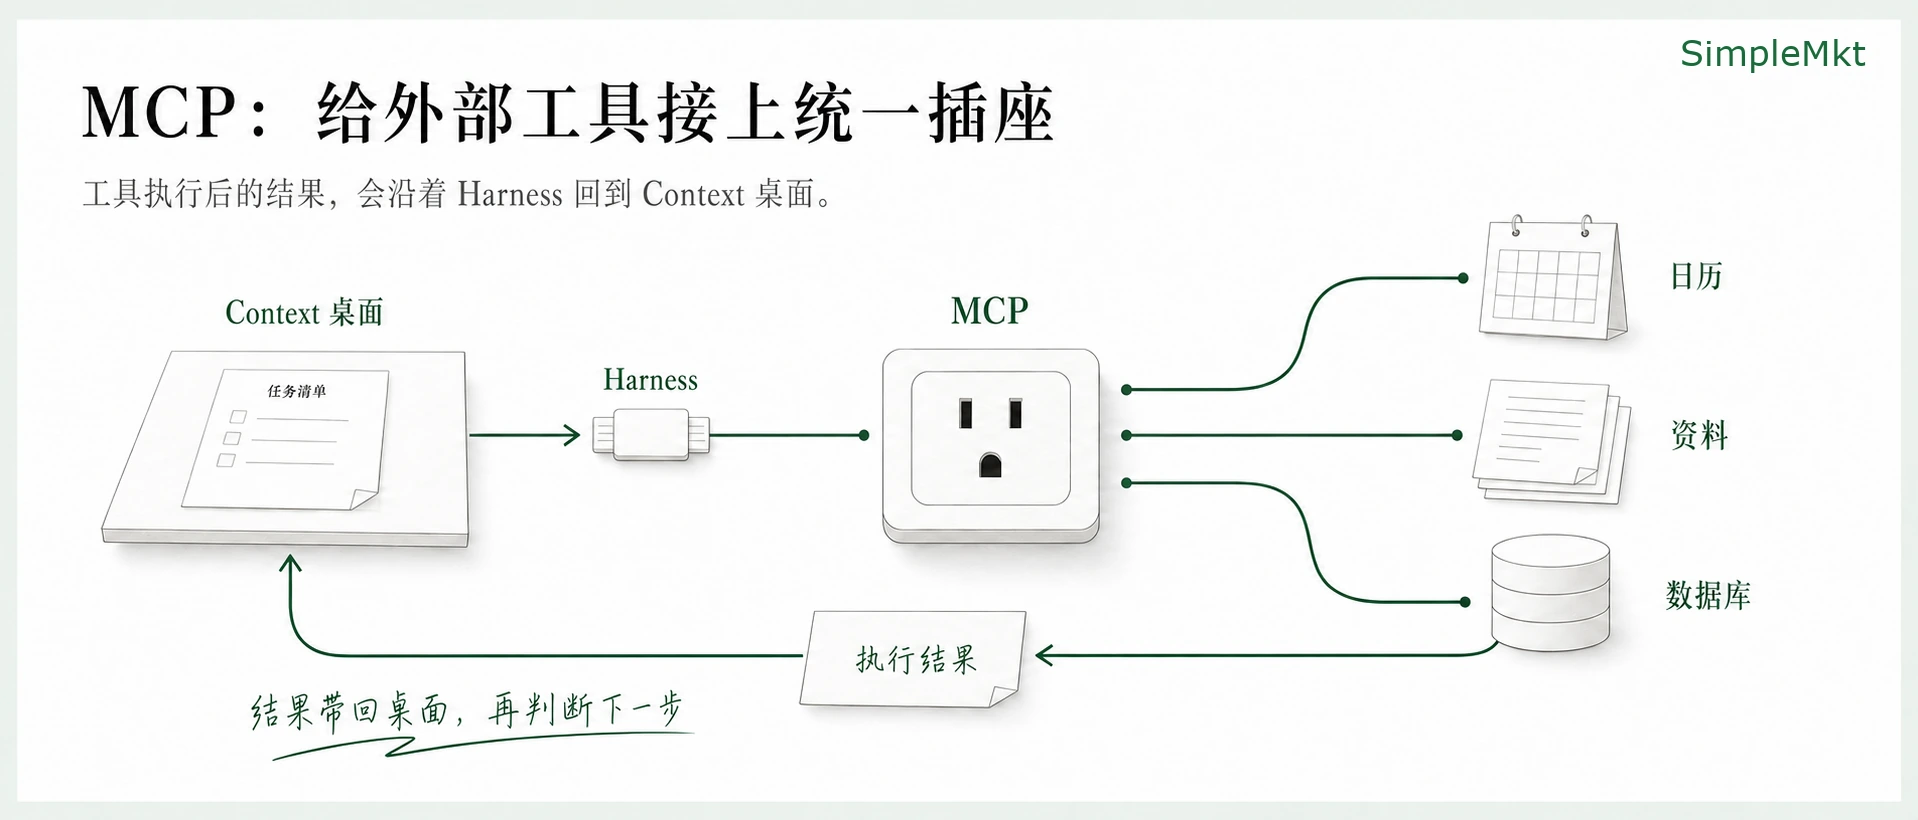
至于日历、Notion、数据库这些外部东西怎么接进来并被Agent调用?是需要一个Agent能懂,工具也能懂的使用契约,或者叫接口,大脑调用工具就像指挥手对接到工具的统一插座上,这个插座叫 MCP。工具做完后会返回具体的执行结果,结果又会通过Harness回到我们之前说的 Context 桌面,大脑继续判断下一步,直到任务完成、失败,或者需要你确认。
7. Skill、Workflow:把经验变成虚拟员工能反复执行的方法
除了上述之外,Agent发展到现在,它的Harness越来越多和复杂。大部分人只要掌握好Agent并能撰写Skill并把过往的工作经验变成一条Wokrflow就很好了。Skill、Workflow是Harness中很重要的两个概念,但也确实只是Harness中很小的一部分,你有多理解LLM和Harness, 决定了你能多大程度上利用Agent干多难多复杂的活。
写在最后:真正拉开差距的,是你给 Agent 配了什么 Harness
如果你不只想关注Skill,还想关注更多的Harnss、LLM、Agent的原理、细节和技巧,或者一些实操方法论,你可以持续地关注我,我会在这个方向持续地发布一些内容出来。